
O que é Jev (System One)? Como funciona a IA de decisões da TypeSafe
Entenda como Jev avalia perguntas tipadas sobre dados, o papel de Choice, Score e Noul e os limites que sua aplicação precisa considerar.
Mais
Revise o prompt antes de enviar. Se ele não aparecer no chat, copie abaixo.
Navegue pelos tópicos deste artigo
Nem sempre sua aplicação precisa que uma IA escreva uma resposta. Às vezes, ela precisa receber uma escolha ou uma avaliação em um formato que o código consiga conferir e usar. Pedir texto livre e tentar extrair esse resultado depois acrescenta uma responsabilidade à integração.
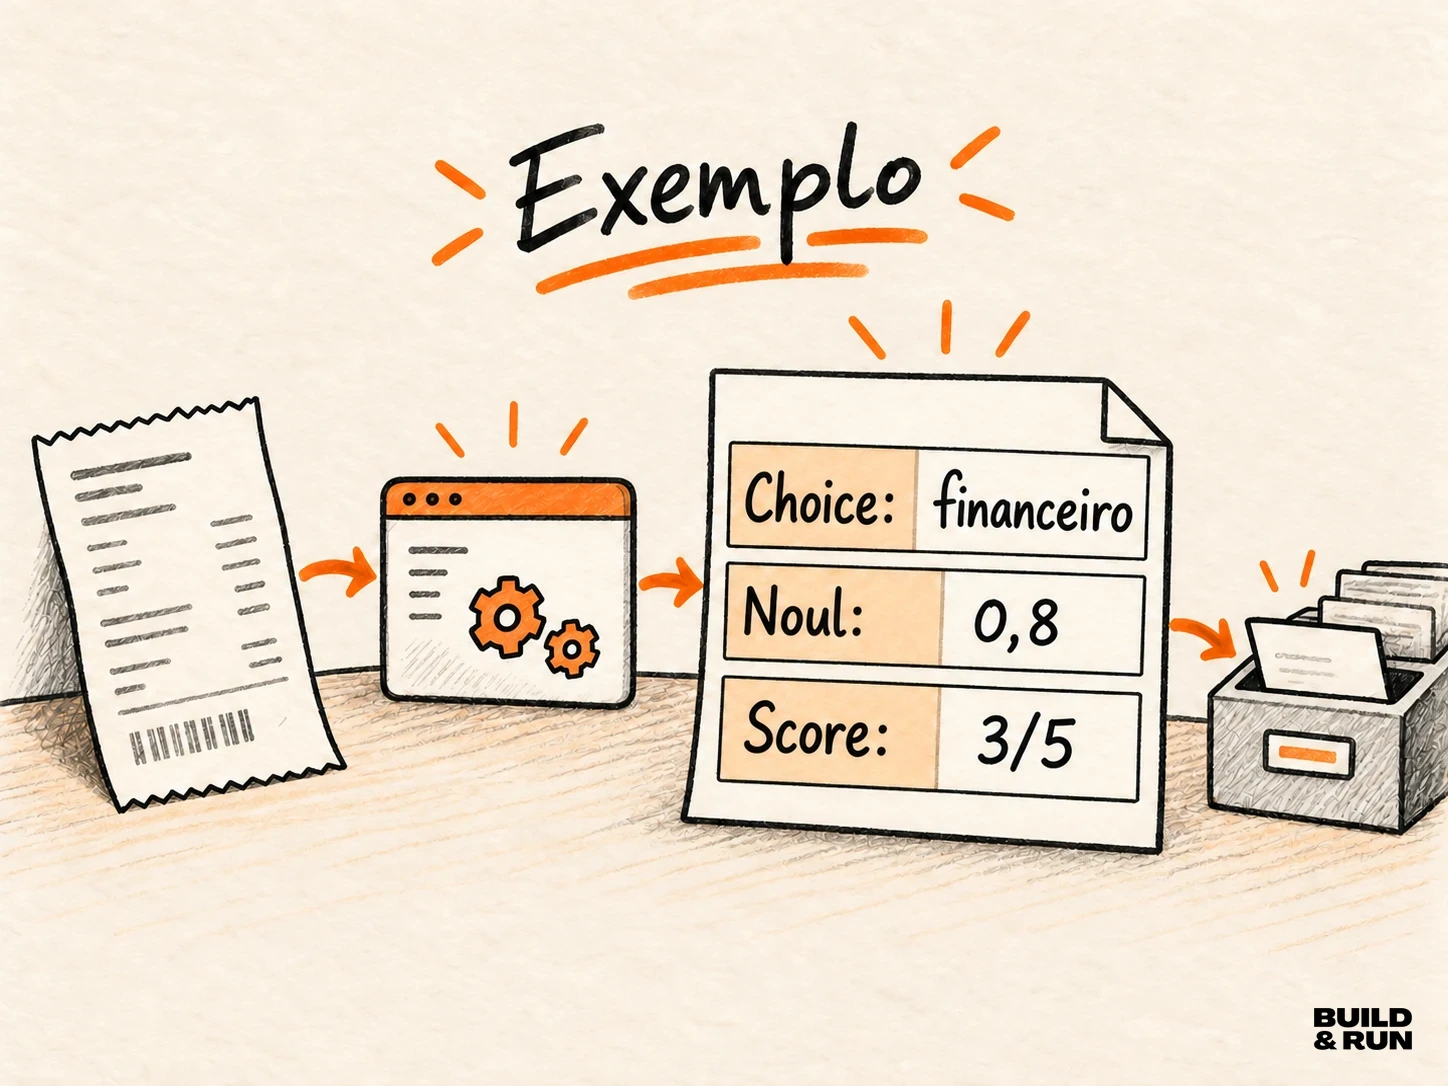
Jev, da TypeSafe, foi criado para esse tipo de tarefa. Ele recebe perguntas específicas sobre dados e devolve resultados estruturados, como uma opção escolhida, uma pontuação ou um valor de verdade. A empresa chama essa categoria de System One.
Para entender onde isso pode ajudar, é importante separar a avaliação feita pelo modelo da decisão que sua aplicação executa. O formato estruturado facilita o uso da resposta; verificar fatos, aplicar regras de negócio e autorizar ações continuam sendo responsabilidades do sistema.
O que significa System One
A TypeSafe descreve System One como uma classe de modelos de IA criada para produzir decisões rápidas e estruturadas que o software consiga consumir. Jev é seu modelo principal e o primeiro dessa categoria. A empresa anunciou o acesso antecipado em 15 de setembro de 2026; na documentação consultada em 27 de outubro, a versão estável mais recente é Jev 1.14.0, lançada em 14 de outubro.
O nome alude à distinção popularizada por Daniel Kahneman entre julgamentos rápidos e intuitivos e raciocínios mais lentos e deliberados. É uma analogia para o tipo de tarefa: avaliações curtas e bem delimitadas. Não significa que o modelo seja uma pessoa, nem que todo problema possa ser resolvido por uma resposta rápida.
Essa diferença aparece no fluxo. Um modelo de linguagem tradicional costuma receber instruções para gerar texto, e a aplicação tenta interpretar esse texto depois. Jev recebe um estado — por exemplo, o texto recebido e os campos relevantes para a avaliação — e perguntas com tipos de resposta definidos. A resposta já vem estruturada para o código verificar e usar. Consulte a introdução oficial ao Jev e a página sobre System One.
Como transformar um chamado em perguntas
Considere agora um chamado com a mensagem: “Fui cobrada duas vezes pela assinatura deste mês. Podem verificar?” A aplicação precisa encaminhá-lo, avaliar se há um pedido de reembolso e identificar casos que precisam de revisão humana.
Ela pode enviar a mensagem como parte do estado e perguntar: “Qual equipe deve receber este chamado?” As perguntas precisam ser específicas. “O que devemos fazer com este cliente?” mistura classificação, política de reembolso, prioridade e atendimento; é mais difícil verificar e controlar do que separar cada decisão.
A TypeSafe oferece três primitivas principais:
| Primitiva | Pergunta que representa | Uso no chamado |
|---|---|---|
| Choice | Qual opção de uma lista se aplica? | Escolher entre cobrança, suporte técnico e conta. |
| Score | Em que nível o estado se encaixa numa escala ou rubrica? | Avaliar a urgência conforme critérios definidos pela aplicação. |
| Noul | Esta afirmação é verdadeira? | Avaliar se a mensagem solicita um reembolso. |
Uma forma conceitual de representar a avaliação seria:
estado = "Fui cobrada duas vezes pela assinatura deste mês. Podem verificar?"

perguntas = [
  Choice("equipe responsável", ["cobrança", "suporte técnico", "conta"]),
  Noul("a pessoa está solicitando um reembolso?"),
  Score("urgência", rubrica_definida_pela_aplicação)
]

resultado = avaliar_com_jev(estado, perguntas)
Este pseudocódigo é apenas didático: não é executável e não representa a assinatura de um SDK. Ele mostra a separação entre o contexto fornecido, as perguntas e o formato esperado das respostas. Na API real, a requisição contém campos estruturados para o modelo, o estado e as perguntas; os detalhes dependem da referência da API e do SDK escolhido.
No fluxo documentado, perguntas independentes podem ser avaliadas contra o mesmo estado em uma solicitação. A aplicação poderia receber, por exemplo, choice: "cobrança" e um resultado de Noul que representa a avaliação sobre pedido de reembolso. Os valores são estruturados, mas não provam que houve cobrança duplicada. Para isso, o backend ainda precisa consultar transações e aplicar a política vigente.
Onde entram probabilidades e confiança
Jev também pode retornar probabilidades associadas às opções ou níveis avaliados. Elas ajudam a aplicação a representar incerteza e criar uma política de encaminhamento. Por exemplo, o time pode aceitar automaticamente uma classificação acima de um limite que tenha validado e enviar casos abaixo dele para uma fila de triagem.
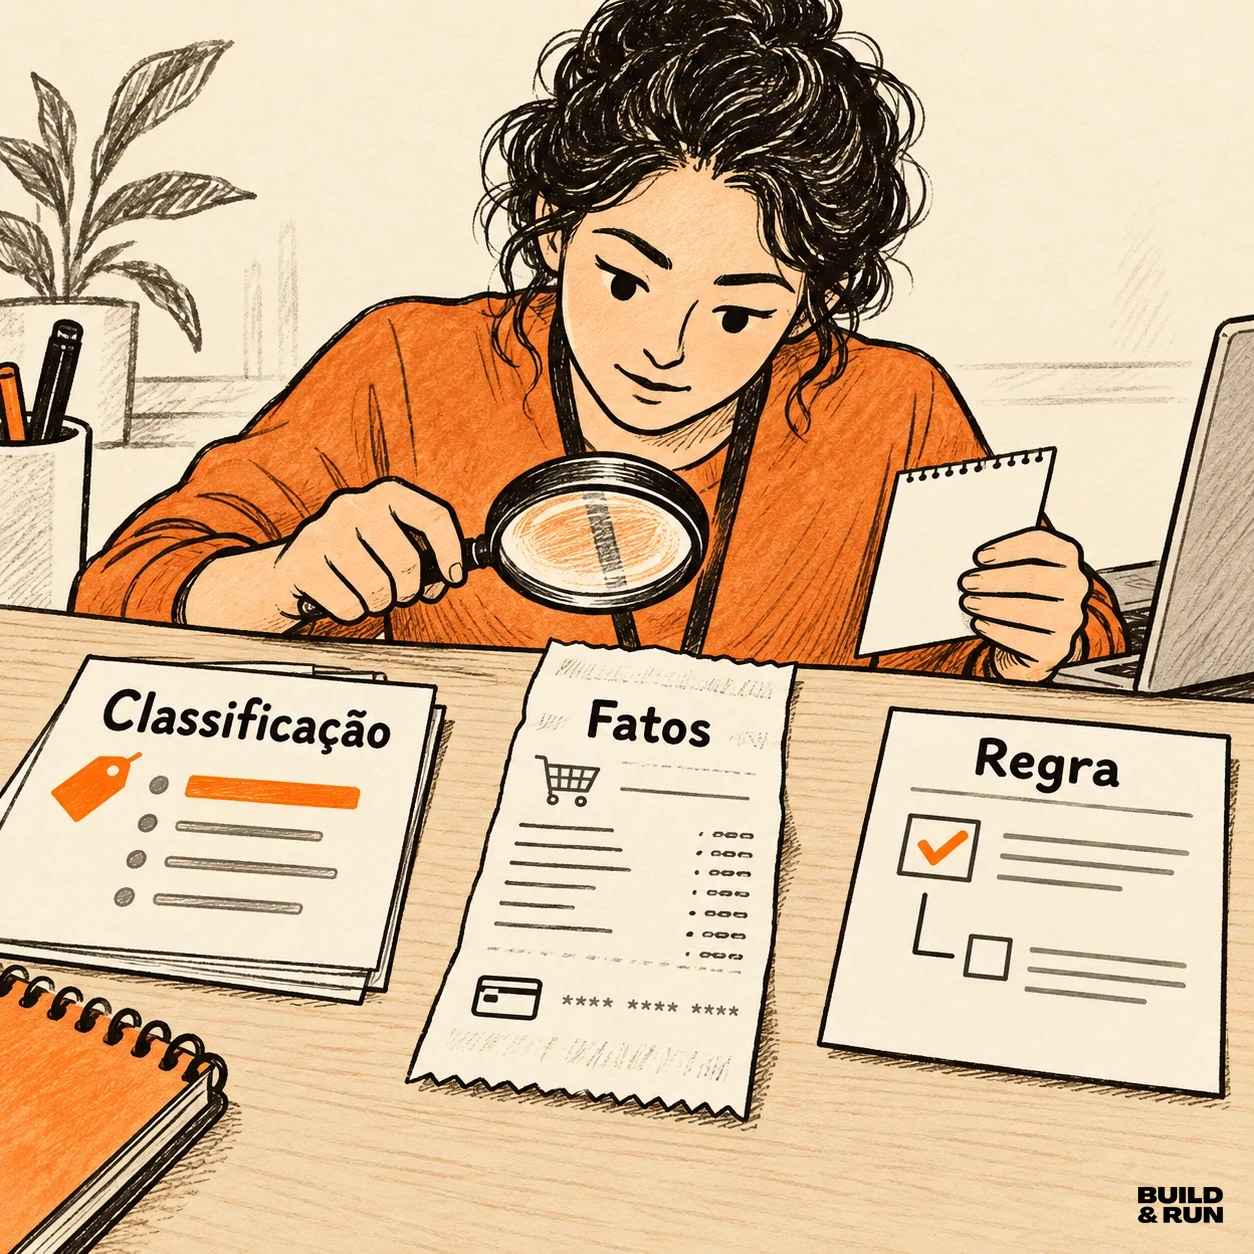
Probabilidade calibrada não é garantia para uma resposta individual. A calibração descreve como previsões se comportam em grupos; não prova que este chamado específico foi encaminhado corretamente. A documentação também distingue probabilidade de confiança, e a confiança só aparece nos tipos de pergunta que a suportam. Portanto, não trate um número retornado como autorização automática para estornar dinheiro ou alterar uma conta.
A decisão final é do sistema que você constrói. Para o chamado fictício, uma política segura poderia usar Jev para sugerir “cobrança”, conferir o histórico de pagamentos no backend e encaminhar o reembolso para aprovação se a evidência ou a avaliação não passar pelos critérios definidos. Os limites, as verificações e a rota de exceção pertencem à aplicação.
O que Jev não faz nesse fluxo
Jev não redige a resposta que será enviada à pessoa, não produz código e não explica o raciocínio em linguagem natural. Se o produto precisa responder “Encontramos duas cobranças e já abrimos uma análise”, outra parte do sistema terá de montar essa mensagem com dados verificados. Se for preciso raciocínio aberto ou uma explicação, a aplicação pode encaminhar o caso a uma pessoa ou a um modelo de linguagem apropriado.
Também não convém transformar uma pergunta ampla em um único julgamento opaco. A recomendação da TypeSafe é decompor avaliações complexas em perguntas menores e combinar os resultados no código. Isso deixa explícito qual critério decidiu o encaminhamento e facilita testar a política quando as regras mudarem.
Limites práticos antes de integrar
A entrada de texto — incluindo strings e estruturas textuais — é o caminho estável documentado para esse fluxo. A página de entrada de imagens documenta suporte nas versões Jev 1.13 e 1.14, com caráter experimental, enquanto a página de conceitos de System One ainda descreve entrada apenas textual. Confira a versão e a configuração da integração antes de contar com imagens; isso não torna Jev um modelo multimodal geral. Para o chamado, use o texto recebido e campos que sua aplicação possa representar como texto ou JSON. Se o atendimento depender de uma imagem, avalie esse recurso separadamente antes de incluí-lo no fluxo.
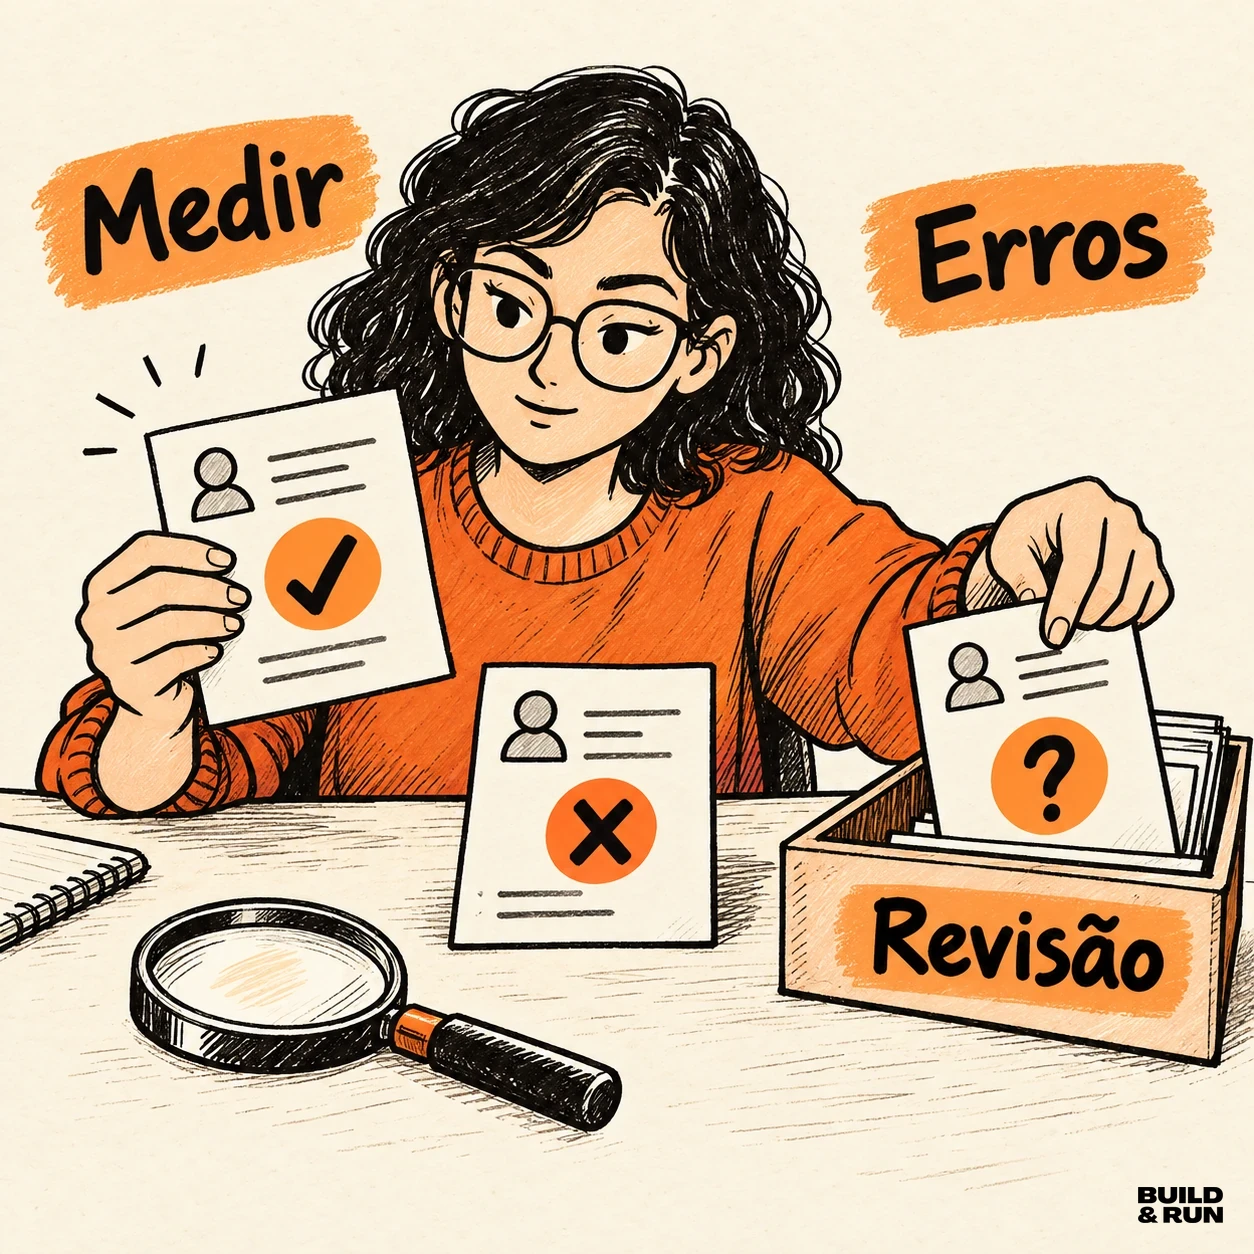
O inglês é o idioma principal de treinamento e aquele em que a TypeSafe relata melhor desempenho. Outros idiomas, incluindo português, são tratados, mas a documentação não afirma desempenho equivalente. Antes de usar Jev para classificar chamados em português brasileiro, monte uma amostra representativa do seu domínio, defina resultados esperados e meça erros por categoria. Acompanhe também os casos encaminhados para revisão; os números de confiança não substituem essa avaliação.
A documentação atual lista limites de contexto padrão e um modo de contexto longo que precisa ser ativado explicitamente. A própria TypeSafe informa que esse modo é mais lento e menos preciso do que permanecer dentro dos limites padrão. Para um chamado curto, não há motivo para começar pelo modo longo. Recursos que estejam em estágio experimental ou com desempenho ainda não verificado devem passar por validação separada antes de sustentarem uma decisão de produção.
Por fim, separar treinamento de retenção ajuda a fazer uma avaliação de privacidade correta. A TypeSafe declara que não treina Jev com solicitações ou respostas de clientes. Isso não significa retenção zero: dados podem ser processados para prestar o serviço, gerar telemetria e cumprir outras finalidades descritas nos termos. Retenção e exclusão dependem dos dados, dos acordos aplicáveis e de eventual configuração contratual de Zero Data Retention. Leia a página de uso e retenção de dados enviados e os termos relevantes para seu caso.
Quando considerar System One
System One faz sentido quando há uma pergunta delimitada, um conjunto de respostas que o software conhece e uma próxima etapa que pode ser expressa em código. No nosso chamado, isso pode significar sugerir uma equipe, avaliar se houve pedido de reembolso e aplicar uma regra explícita de revisão.
A integração exige mais do que chamar um modelo: é preciso definir o estado e as perguntas, medir o comportamento no idioma e nos dados do produto, escolher limites com evidência e manter uma saída segura para casos incertos. Jev fornece avaliações estruturadas para esse fluxo; sua aplicação continua responsável por validar fatos, aplicar políticas e decidir o que acontece em seguida.
Se esse tipo de decisão aparece no backend que você está construindo, os conteúdos da Formação Build & Run ajudam a conectar fundamentos de programação com aplicações e IA.
Continue lendo
Minha aplicação funciona no computador. Como coloco no ar?
Entenda servidor, configuração, banco, domínio e deploy com um exercício local seguro e um roteiro para publicar e observar sua primeira aplicação.
Bruno Rana ·
O que faz um desenvolvedor backend? Da requisição à resposta
Acompanhe uma reserva de livro para entender o trabalho backend: receber pedidos, aplicar regras, proteger dados, usar o banco e investigar falhas.
Bruno Rana ·
Portfólio backend: como sair do clone de tutorial
Transforme um projeto guiado em uma API que você consegue explicar: problema, regra de negócio, testes, decisões e documentação reproduzível.
Bruno Rana ·