# O que é RAG? Como funciona e quais dados podem ser enviados à IA
Entenda como funciona RAG, quais dados podem seguir para embeddings e geração e como conferir permissões, contexto, armazenamento e logs.
Por Bruno Rana
Publicado em: 2026-10-22
Atualizado em: 2026-11-04
Artigo original: https://buildrun.com.br/blog/rag-envia-documentos-para-ia/
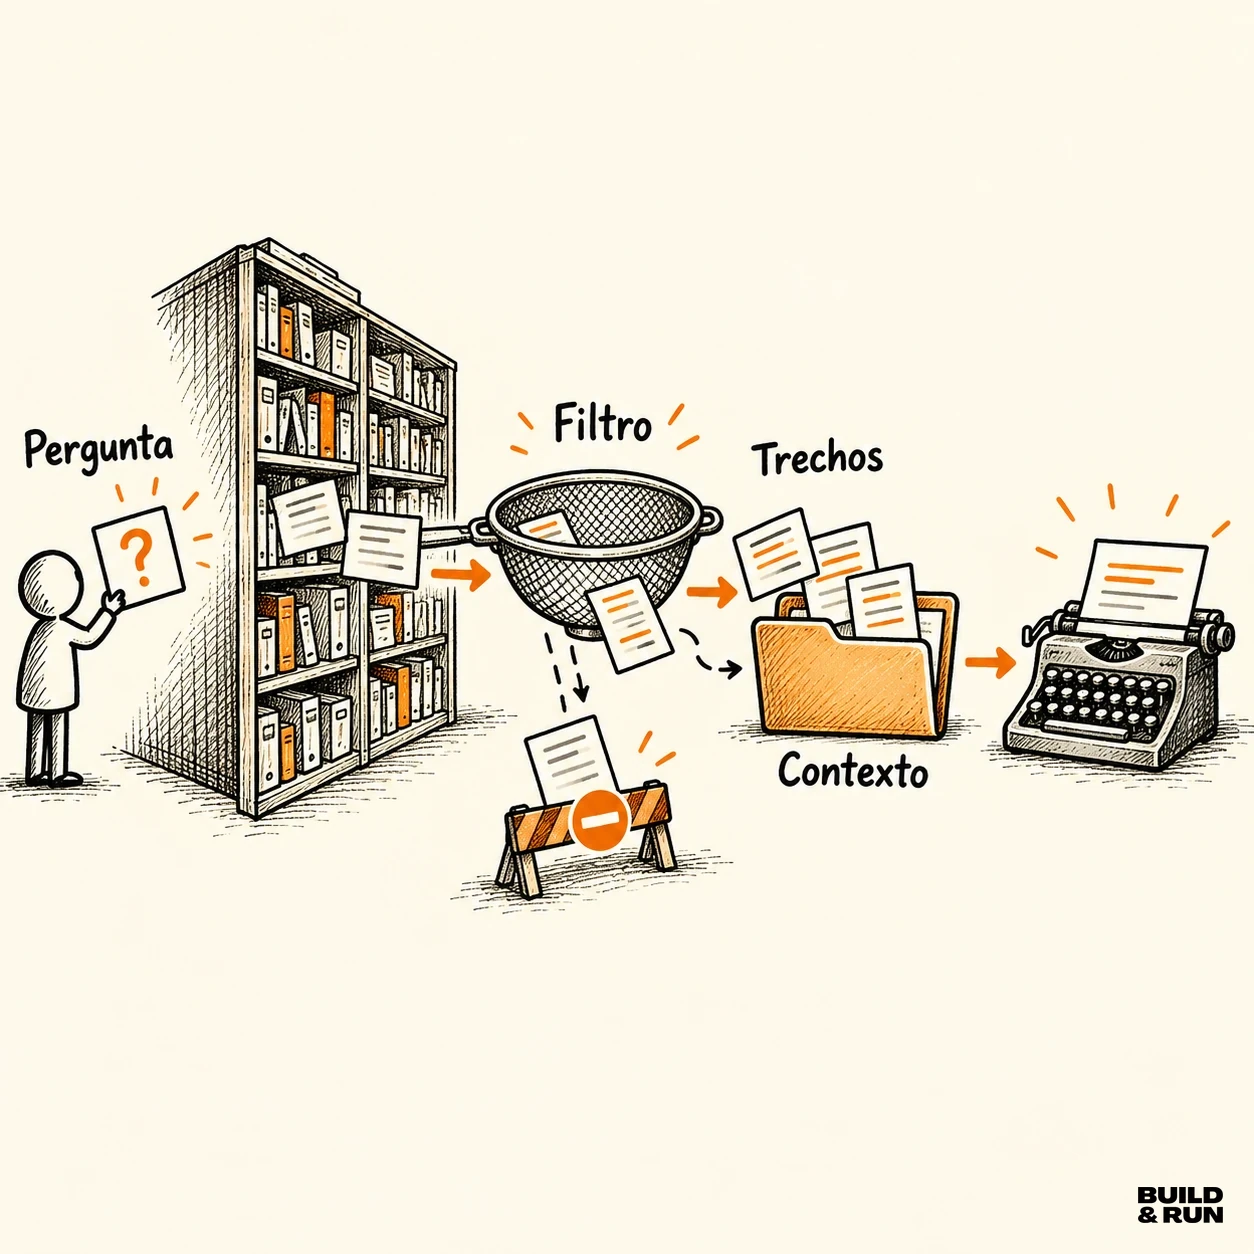
A biblioteca representa o índice. A aplicação filtra acesso e versão, seleciona trechos relevantes e envia esses trechos com a pergunta ao modelo.
Ao conectar documentos a uma IA, é natural querer saber o que sai do seu sistema e chega ao modelo. A resposta depende do caminho que os dados percorrem. Saber apenas que a aplicação usa RAG ainda não esclarece quais serviços recebem conteúdo, o que é armazenado ou quem pode consultar cada informação.
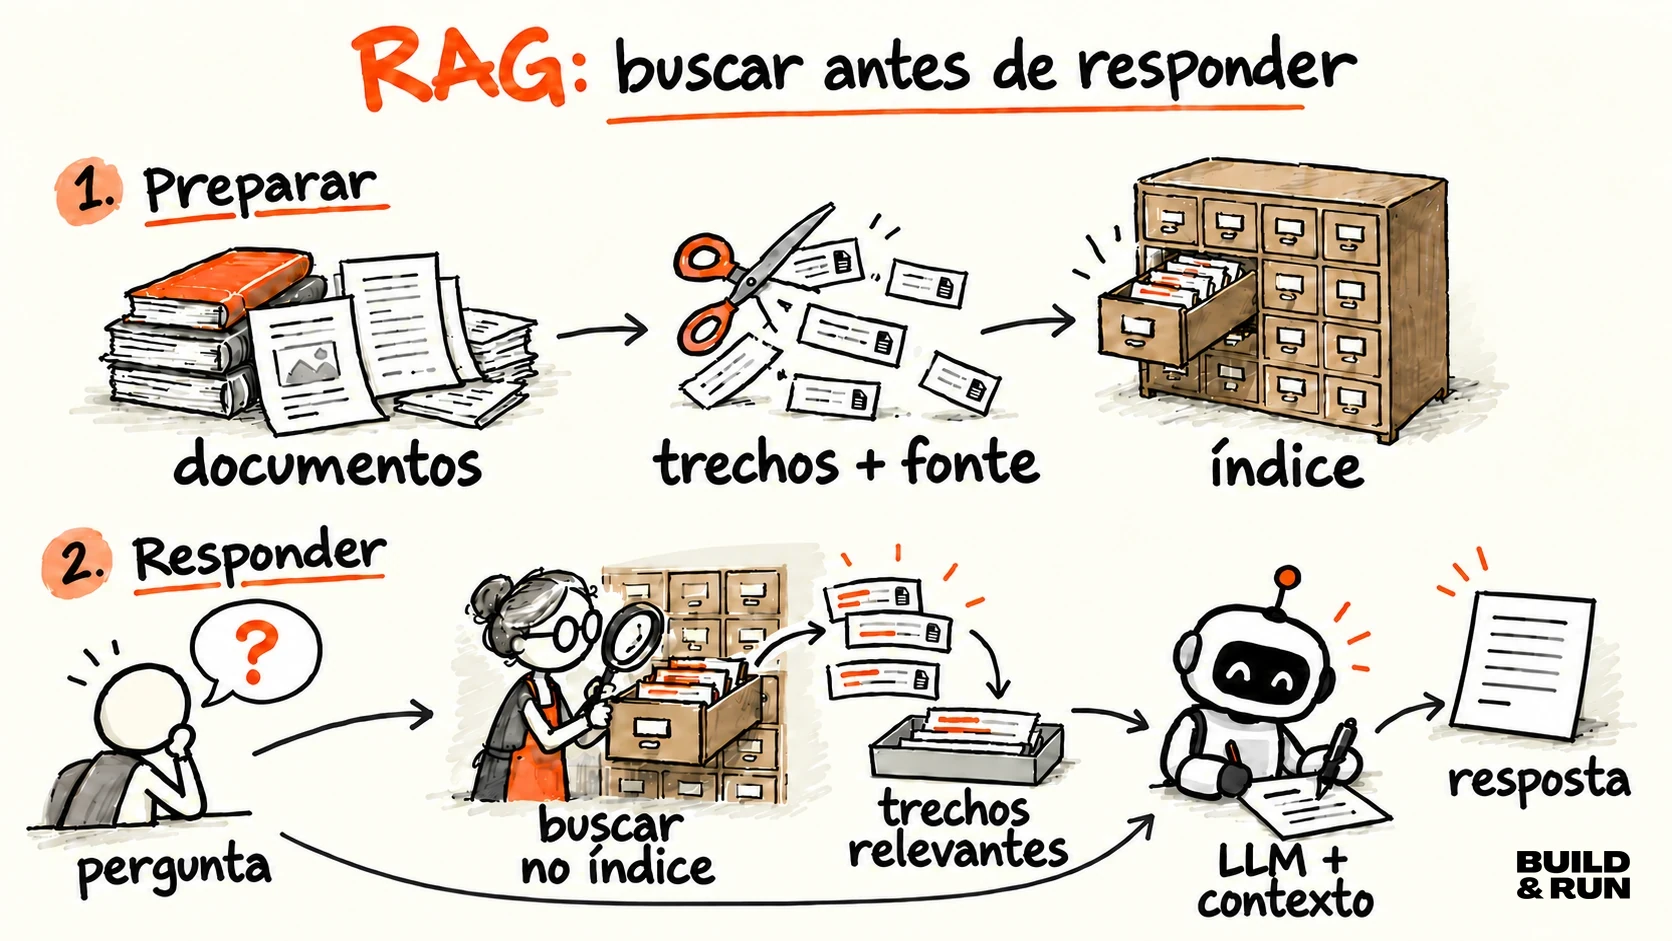
**RAG, geração aumentada por recuperação**, combina uma busca nas suas fontes com a geração da resposta. A aplicação seleciona trechos relevantes e os envia como contexto junto da pergunta. Isso permite trabalhar sem mandar o acervo inteiro em cada consulta, mas não significa que os documentos permaneçam locais em todas as etapas.
Para conferir essa fronteira, precisamos olhar tanto a preparação dos documentos quanto o momento da pergunta. Extração, embeddings, armazenamento e logs podem ter destinos diferentes; permissões e versões precisam continuar valendo ao longo desse percurso.
## O manual que vamos acompanhar
Nosso documento fictício é o **Manual do Simulador Farol, versão 2**. Ele tem três seções:
| Seção | Conteúdo | Acesso |
| --- | --- | --- |
| Reinício | Encerre a simulação em andamento, abra Configurações > Reiniciar e aguarde 20 segundos. O reinício preserva as preferências. | Todos os usuários autenticados. |
| Redefinição de preferências | Abra Configurações > Restaurar preferências para voltar aos valores padrão. As preferências personalizadas serão apagadas. | Todos os usuários autenticados. |
| Diagnóstico técnico | Abra Diagnóstico > Exportar relatório para gerar o relatório técnico. | Apenas usuários com o papel de técnico. |
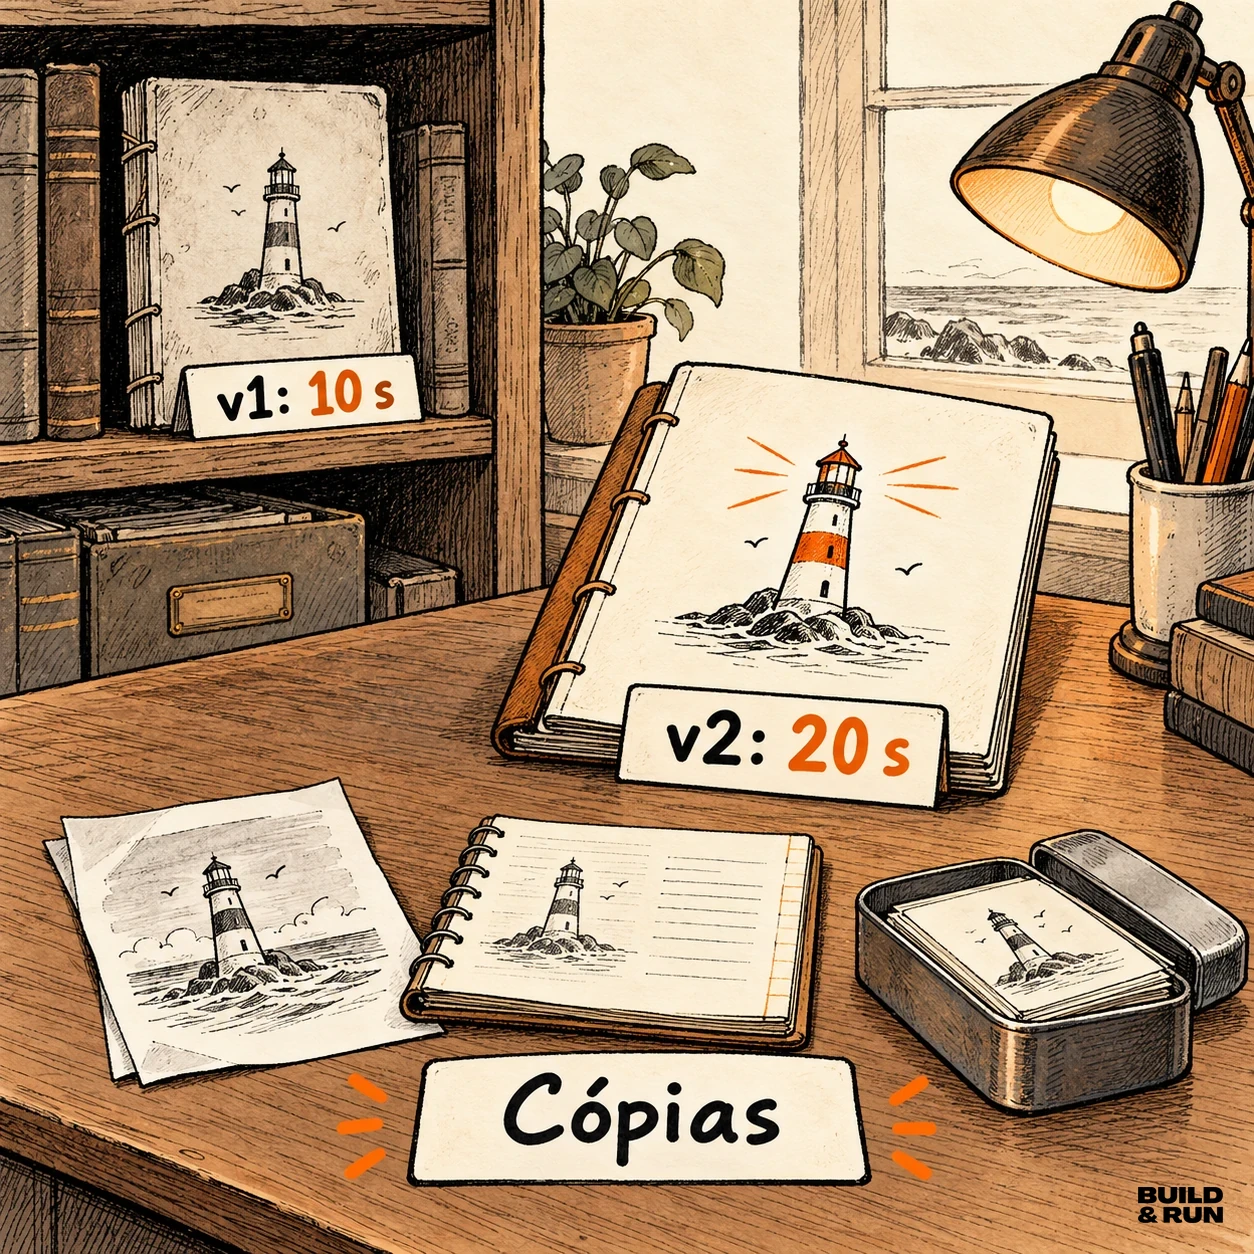
A versão 1 desse mesmo manual orientava aguardar 10 segundos no reinício. Ela foi substituída pela versão 2 e não deve sustentar respostas atuais. Vamos usar duas identidades de teste: uma pessoa com acesso comum e outra com o papel de técnico.
A pergunta principal será: **“Como reinicio o Simulador Farol sem perder minhas preferências?”** Ao final, retiraremos a seção de diagnóstico do acervo para verificar a remoção. Esses são os dados e as regras do nosso exercício; o procedimento não corresponde a um produto real.
## Primeiro caminho: preparar o manual para a busca
A preparação dos documentos é a ingestão. Ela acontece antes da pergunta e pode ser repetida quando o material muda. A [documentação de ETL do Spring AI](https://docs.spring.io/spring-ai/reference/api/etl-pipeline.html) organiza esse trabalho em leitura, transformação e escrita. Cada etapa tem seu próprio destino de dados.
### Extrair o texto
A aplicação lê o arquivo do manual e extrai seu conteúdo. Se o leitor funcionar dentro do processo da aplicação, essa etapa pode permanecer local. Se o arquivo for enviado a um serviço externo de leitura ou OCR, o conteúdo já cruzou uma fronteira antes de chegar ao modelo que responderá à pergunta.
Isso importa especialmente para a seção Diagnóstico técnico. A restrição de acesso dos usuários deve ser preservada durante a preparação, e os serviços contratados precisam estar autorizados a processar esse conteúdo. Uma permissão de leitura na aplicação não define, sozinha, quais fornecedores podem recebê-lo.
### Dividir sem perder as condições do procedimento
A aplicação divide o texto em trechos recuperáveis. Na seção Reinício, separar “encerre a simulação em andamento” do restante pode fazer a busca devolver um procedimento incompleto. O trecho precisa preservar essa condição, o caminho do menu, a espera de 20 segundos e a informação sobre as preferências.
A seção Redefinição de preferências deve continuar identificável como outro procedimento. Ela compartilha palavras com a pergunta, mas sua ação apaga exatamente o que a pessoa quer preservar. Essa diferença terá de sobreviver à extração e à divisão do documento.
Associe a cada trecho metadados como identificador do manual, seção, versão e regra de acesso. Esses campos devem vir de fontes controladas pela aplicação. Um rótulo de permissão extraído livremente do texto do documento não deve conceder acesso.
### Produzir embeddings e armazenar
Na busca vetorial, um modelo transforma o texto de cada trecho em uma representação numérica, o embedding. Se esse modelo for remoto, os textos enviados para produzir os vetores sairão da aplicação. Executar a geração de respostas localmente não altera esse envio anterior.
O índice pode armazenar vetor, texto e metadados. Confira os registros reais: ter um banco vetorial não significa guardar apenas números, nem torna o conteúdo automaticamente anônimo. A [referência de bancos vetoriais do Spring AI](https://docs.spring.io/spring-ai/reference/api/vectordbs.html) descreve armazenamento e busca por similaridade; o controle de acesso depende do desenho da aplicação.
Ao terminar a ingestão, precisamos saber onde estão o arquivo original, o texto extraído e os registros de cada seção. Também precisamos distinguir a versão vigente das cópias antigas e conhecer o destino dos backups.
## Segundo caminho: responder à pergunta
Agora a pessoa com acesso comum pergunta como reiniciar o Simulador Farol sem perder as preferências.
Aplique permissão e versão antes de enviar texto a seletores ou geradores externos.
### Recuperar dentro das permissões
A aplicação autentica a pessoa e obtém suas permissões no servidor. Na busca vetorial, normalmente também produz um embedding da pergunta. Se esse serviço for externo, **a própria pergunta será transmitida a ele**, mesmo que nenhum trecho restrito participe da busca.
A recuperação deve considerar o escopo autorizado e a versão vigente. Reinício e Redefinição de preferências podem aparecer como candidatos por tratarem de configurações do simulador. Similaridade ajuda a localizá-los, mas não decide qual procedimento responde à pergunta.
Diagnóstico técnico está fora do acesso dessa identidade. Seus trechos não devem chegar ao contexto, a serviços externos de seleção ou à resposta por reutilização de cache. Filtros por metadados ajudam quando os campos são confiáveis e as regras são aplicadas corretamente. Aceitar da requisição um papel de “técnico” sem validá-lo no servidor não estabelece autorização.
### Selecionar e montar o contexto
A aplicação escolhe o material que sustentará a resposta. No fluxo descrito pela [referência de RAG do Spring AI](https://docs.spring.io/spring-ai/reference/api/retrieval-augmented-generation.html), os documentos recuperados são acrescentados à pergunta como contexto.
Para a nossa consulta, o trecho de Reinício contém a orientação necessária. Uma chamada conceitual seria:
> **Pergunta:** Como reinicio o Simulador Farol sem perder minhas preferências?
>
> **Contexto:** Manual do Simulador Farol, versão 2, seção Reinício. Encerre a simulação em andamento, abra Configurações > Reiniciar e aguarde 20 segundos. O reinício preserva as preferências.
>
> **Orientação da aplicação:** Responda com base no contexto. Se ele não sustentar a resposta, informe a insuficiência.
O gerador recebe **texto legível**. O vetor ajudou a encontrar o registro; ele não substitui o texto do manual nessa chamada. Instruções adicionais e histórico de conversa, quando incluídos, também fazem parte do envio e ocupam a janela de contexto do modelo.
O pseudocódigo abaixo mostra a ordem das decisões. Os nomes representam operações conceituais, não métodos de uma biblioteca:
```text
identidade = autenticar(requisicao)
escopo = obter_permissoes_no_servidor(identidade)
versao = obter_versao_vigente("manual-farol")
pergunta = requisicao.pergunta
# Um provedor remoto de embeddings receberia a pergunta aqui.
vetor = produzir_embedding(pergunta)
candidatos = buscar(vetor, manual="manual-farol", versao=versao, escopo=escopo)
permitidos = validar_acesso_e_versao(candidatos, identidade, versao)
selecionados = selecionar_evidencia(permitidos, pergunta, limite_do_contexto)
se selecionados estiver vazio:
retornar "Não encontrei informação autorizada suficiente."
contexto = reunir_textos_e_referencias(selecionados)
# Um gerador remoto receberia a pergunta e os textos selecionados.
resposta = gerar(pergunta, contexto)
retornar resposta
```
A validação precisa acontecer antes do envio. Pedir ao modelo que não revele a seção restrita não corrige uma chamada que já a incluiu. O mesmo cuidado vale para caches e histórico: uma resposta produzida para a identidade técnica não pode ser reaproveitada para a identidade comum sem respeitar as permissões.
### Conferir a resposta contra a fonte
A resposta deve preservar o encerramento da simulação, o caminho Configurações > Reiniciar, a espera de 20 segundos e a manutenção das preferências. Se orientar a usar Restaurar preferências, terá confundido os procedimentos. Se omitir a condição inicial, terá perdido uma parte necessária da orientação.
Exibir uma referência ao manual ajuda a conferir a origem, mas não garante que a resposta esteja correta. Relacione a afirmação ao trecho e à versão realmente enviados. Se nenhuma das três seções sustentar uma resposta, a aplicação deve comunicar a insuficiência de evidência.
Nos testes, registre o resultado esperado, o contexto enviado e a resposta obtida. Se o contexto estava errado, investigue a ingestão e a recuperação. Se estava correto e a resposta mudou a orientação, investigue a geração.
## O que acontece com a versão antiga e a seção removida?
Substituir o arquivo original não demonstra que os registros da versão 1 desapareceram da busca. Uma ingestão que apenas acrescenta entradas pode deixar as duas versões disponíveis.
Retirar do índice não comprova que todas as cópias foram eliminadas.
Repita a pergunta sobre reinício e inspecione o contexto. Ele deve trazer a versão 2 e a espera de 20 segundos. Uma resposta final com “20 segundos” não basta como evidência: o modelo pode ter recebido também o trecho antigo de 10 segundos e escolhido um deles.
A aplicação precisa de uma regra explícita para identificar, substituir ou desativar trechos anteriores. Se mantiver histórico, deve separá-lo do material vigente usado nessa consulta.
Depois, retire a seção Diagnóstico técnico do acervo e consulte “Como exporto o relatório de diagnóstico?” com a identidade técnica. Ela tinha acesso à seção, mas agora não deve recuperá-la. Esse teste separa a remoção do controle de permissões: a identidade comum já não poderia recebê-la antes.
Confira índice, contexto e caches. Arquivo original, backups e logs podem ter ciclos de exclusão diferentes. Retirar um registro da busca não comprova que todas as cópias do conteúdo foram eliminadas.
## Logs, retenção e treinamento também fazem parte do caminho
Para enxergar as fronteiras do nosso manual, registre os destinos reais de cada etapa:
| Etapa | Conteúdo que pode chegar ao destino |
| --- | --- |
| Extração | Arquivo do manual e texto extraído. |
| Embeddings da ingestão | Textos das três seções, conforme o processamento autorizado. |
| Índice | Vetores, textos e metadados de versão e acesso. |
| Embedding da consulta | Pergunta sobre o Simulador Farol. |
| Geração | Pergunta, instruções, histórico incluído e trechos selecionados. |
| Observabilidade | Dados registrados em logs, traces e diagnóstico. |
Preencha essa relação com os componentes e fornecedores efetivamente usados. Uma etapa desconhecida continua sendo uma dúvida sobre o destino dos dados, não uma evidência de que eles ficaram locais.
A [documentação de observabilidade do Spring AI](https://docs.spring.io/spring-ai/reference/observability/index.html) descreve opções de registro de prompts e respostas e alerta para a exposição de conteúdo sensível. Verifique as configurações da versão adotada e as ferramentas conectadas. Para este diagnóstico, o manual fictício permite observar o fluxo sem registrar documentos reais.
Retenção e treinamento são perguntas diferentes. Retenção trata de quais dados permanecem armazenados e por quanto tempo. Uso para treinamento trata de sua utilização para ajustar modelos. Indexar o manual e recuperá-lo como contexto não altera, por si só, os pesos do gerador; a [referência de conceitos do Spring AI](https://docs.spring.io/spring-ai/reference/concepts.html) diferencia RAG e fine-tuning. Ainda assim, é necessário conferir as condições de uso de dados de cada serviço, produto e contrato envolvidos.
## Próximo passo com a formação
Ao perguntar se um RAG envia documentos para a IA, acompanhe cada chamada: o texto usado nos embeddings, a pergunta vetorizada, os trechos legíveis entregues ao gerador e o conteúdo registrado fora desse percurso. Permissões e versões precisam valer antes do envio; retenção exige verificar também o que permanece depois dele.
As referências oficiais do Spring AI citadas foram consultadas em 22/10/2026. A documentação consultada se identifica como Spring AI 2.0.1; o artigo descreve conceitos e exercícios, sem prescrever uma configuração executável dessa versão.
Se você quer estudar IA junto às decisões de uma aplicação, consulte os [conteúdos da Formação Build & Run](https://buildrun.com.br/blog/formacao-buildrun/). Use o percurso do manual como roteiro para investigar os destinos, as permissões e as evidências do seu próprio projeto.